単一の開始フレーム
1枚の画像が視覚入力のすべてです。
Happy Horse 1.0 AI動画モデルは、1枚の静止画像と1つの文から、すでにあるフレームに動きを生み出します。
作成を始めるには、デスクトップのブラウザでこのページを開いてください。
Happy Horse AI動画モデルは、Virseの動画ラインナップの中で他のどれよりも入力が少なくて済み、その絞り込まれた設計こそがこれを使う理由です。
ほとんどの動画モデルは、あなたが用意している以上のものを求めます。最初のフレームと最後のフレーム、役割を明示した複数の参照画像、カメラの動きやサウンドデザインを網羅した概要などです。手元に写真が1枚だけあり、それが動くところを見たい場合、そうしたモデルでは、持っていない素材を考え出さなければなりません。このモデルは、実際にあなたがいる地点、つまり1枚の開始フレームと、その次に何が起こるかの説明から始められます。
出発点がすでに存在しているときは、Happy Horse AI動画モデルを使用してください。写真をアニメーション化し、生成された静止画に命を吹き込み、アイデアが動きとして成立するかをテストし、最初に概要を組み立てることなく短いクリップを制作できます。
Happy Horse 1.0は、統合されたシングルストリームTransformerを基盤とする150億パラメータの動画生成モデルであり、別々の段階ではなく単一のフォワードパスで映像と音声を生成する初のモデルです。2026年4月にArtificial Analysisのブラインドテストのリーダーボードで1位に入り、商用ライセンスの下でオープンソースとして公開されています。
このモデルは、3つの大きな強みを中心に構築されています。
クリップの長さは5〜8秒で、アスペクト比は16:9、9:16、4:3、21:9、1:1に対応しています。Virseで提供される構成では、1枚の開始フレームとテキストプロンプトをもとに、映像とともに音声を生成します。
1枚の画像が視覚入力のすべてです。
段階的なパイプラインではなく、統合された単一ストリームTransformer。
基盤モデル内で映像と音声を同時に生成。
アップスケールではなくフルHD出力。
1回のパスで生成されるクリップの長さ。
16:9、9:16、4:3、21:9、1:1。
必要なのは1枚の画像と1つの文だけです。参照セットを集める必要も、終了フレームを設計する必要もないため、画像を持っている状態からそれが動く様子を見るまでの最短ルートになります。
無音のクリップを作ってから後で音楽を付けるのではなく、音声と動画を1回のフォワードパスで生成することを実証するために作られたモデルです。この方法でブラインドテストのランキング首位に達しました。
フルHDがモデルから直接出力されます。単一フレーム駆動のモデルとしては、入力要件から想像されるよりも高い上限です。
同じブリーフから横長、縦長、正方形、ウルトラワイドに対応できます。1本のクリップを複数の場所に表示する必要がある場合に重要です。
このモデルは商用利用が許可された形でオープンに公開されていますが、Virseではインストール不要のホステッドサービスとして動作します。
音声は映像と同じパスで生成され、オフにするスイッチはありません。
1フレームのモデルは、試す価値の基準を変えます。入力がすでに持っている画像であれば、問題はブリーフを作るかどうかではなく、単に好奇心があるかどうかになります。 Virseなら、その好奇心を低コストで行動に移せます。画像モデルで生成したものでも、他からドラッグしてきたものでも、キャンバス上のあらゆる静止画を、ワークスペースを離れることなくHappy Horse AI動画モデルに渡せます。
ワークスペースにすでにある任意の静止画を、先にエクスポートすることなく動かせます。
より重いモデル向けにリファレンスセットへ投資する前に、構図がモーションとして機能するか確認できます。
キャンバスを離れたりブリーフを書き直したりすることなく、Happy Horse AI動画モデルと30以上の他の画像・動画モデルを行き来できます。
ショットを特定の締めの構図に着地させる必要がある場合は、両方の端点を受け付けるモデルに同じフレームを渡します。
すでに手元にある商品ショット、ロケーション、またはポートレートにモーションを追加。
キャンバス上の任意の画像を短い動画クリップに変換。
既存の単一アセットから短い縦長または正方形の動画を生成。
さらに作業を進める前に、静止画がモーションとして伝わるかをすばやく確認。
すでにある商品ショットから始まる、ゆっくりとしたプッシュまたはドリフト。
静的なシーンに、湯気、風、光の変化などの環境モーションを追加。
画像をアップロードするか、キャンバス上の別の場所からドラッグして移動します。
何が動くのか、カメラがどう振る舞うのかを説明します。3つの動作よりも1つの動作のほうが伝わりやすくなります。
絵を見る前にペースを判断します。リズムの問題は指示文から生じます。
動きが違う場合は、入力画像を置き換えるのではなく、動きの記述を書き直します。
有用なHappy Horse AI動画プロンプトには、通常3つの要素が含まれます:
こう書く代わりに
この画像に命を吹き込み、映画のような動きで、美しく。
こう書く
カメラはフレームの中央へ向かって、ゆっくりと安定して寄っていく。カップからは細く途切れない湯気が立ち上る。それ以外は何も動かず、カットもない。
カメラは完全に固定します。 マグカップから湯気が細く途切れない流れで立ち上り、わずかに右へ流れます。 フレーム端のカーテンがかすかに動きます。シーン内のそれ以外のものは変化しません。 カットなし、カメラ移動なし、光の変化なし。
カメラはフレーム中央の商品に向かって、ゆっくり均一に寄っていき、ショットいっぱいになる前に止まります。 商品自体は動かず、回転もしません。 光は固定されたままなので、フレーミングが狭まるにつれてハイライトが表面をわずかに移動します。 カットなし。
カメラは一定の速度でゆっくり左へ流れます。 前景の草が軽い風で揺れます。雲の影が中景を徐々に通過します。 水平線は終始水平のままで、何もフレーム内に入ってきません。 構図がフレーム幅の4分の1だけ左にずれた状態で終わります。
| 比較項目 | Happy Horse AI Video | Seedance 2.0 |
|---|---|---|
| ビジュアル入力 | 1枚の開始フレーム | フレームまたは参照セット |
| エンドポイント制御 | 開始フレームのみ | 最初と最後のフレーム |
| Virseでの出力 | 無音 | 映像とともに生成される音声 |
| クリップの長さ | 5〜8秒 | 4〜15秒 |
| 必要な準備 | 1枚の画像と1文 | 動作と音を含む指示文 |
| 選ぶべき場面 | 1枚の写真と問いがある場合 | ショットを特定の到達点に収める必要がある場合 |
フレーム自体で見た目はすでに確立されています。プロンプトは何が変化するかに使いましょう。
5〜8秒で表現できるのは、起こること1つです。複数の要素を積み重ねたブリーフでは、それらがすべて同時に、しかも不自然に出てしまいます。
静的な要素を明示することが、モデルがシーン全体をアニメーション化してしまうのを防ぎます。
音声は生成のたびにレンダリングされるため、プロンプトには環境音、効果音、台詞の手がかりを書く価値があります。
次の動画に向けて、参照画像とビジュアルの方向性を準備しましょう。
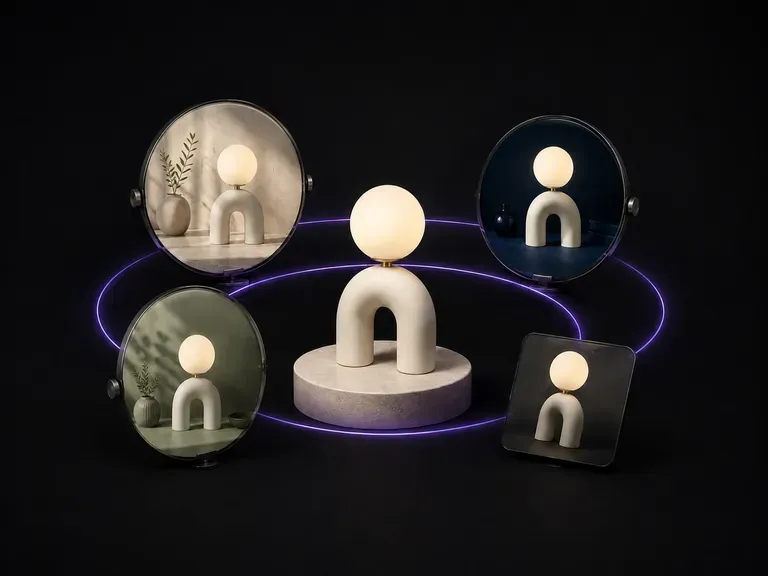
プロダクトをさりげなく変えてしまうバリエーションは、バリエーションではなく別のプロダクトです。画像を1枚アップロードし、変えるべきなのがシーン、色、またはアングルのどれかを指定すれば、それ以外はすべてそのまま保たれた一括生成結果が返ってきます。無料クレジットで、被写体が実際に一括生成を通して維持されるかを十分にテストできます。
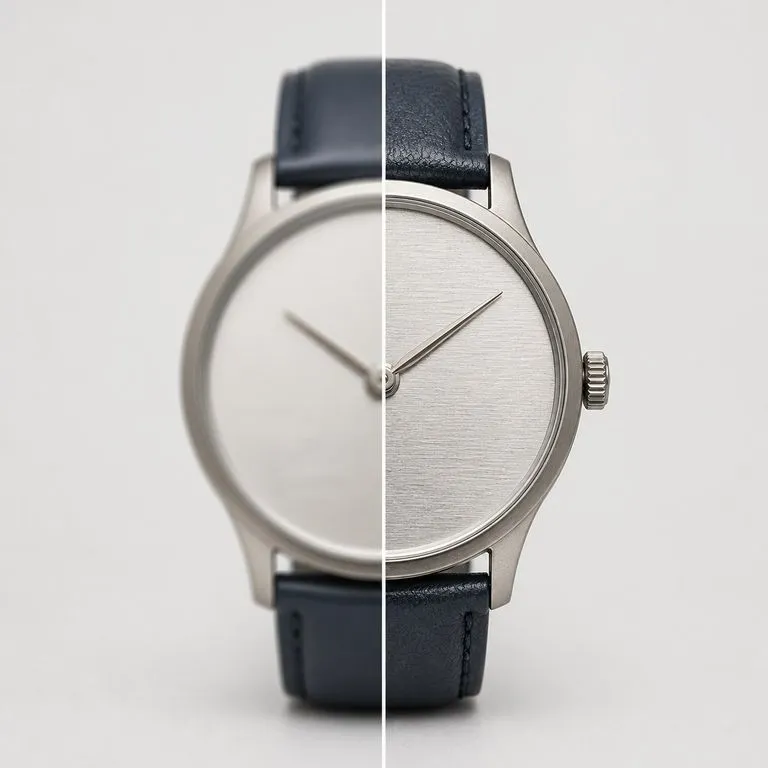
使用するには品質が不十分な写真をアップロードしてください。ブレ、ノイズ、圧縮アーティファクト、または単にピクセル数不足など、実際に何が問題だったのかを特定し、まずそれを修復してから、選択した解像度でレンダリングします。
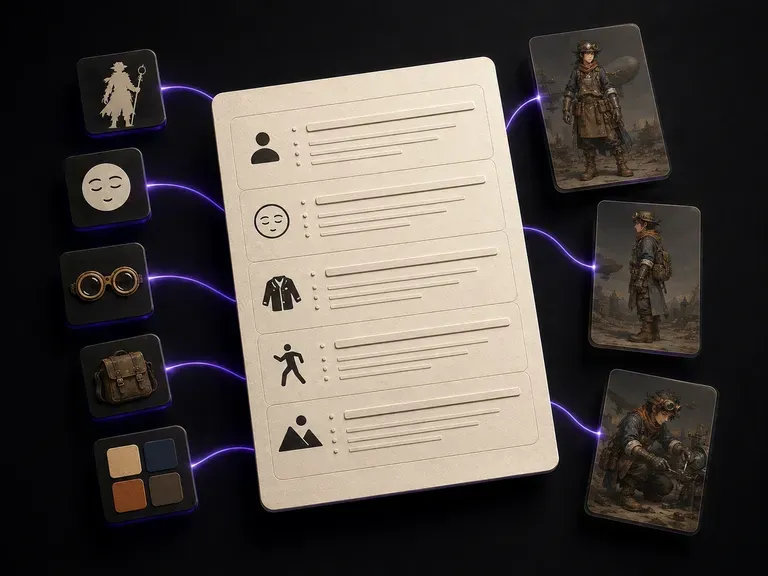
多くのキャラクタープロンプトは、人が読むと問題なく見えても、画像モデルではうまく機能しません。アイデンティティ、世界観、ビジュアルスタイルが、モデルが解析できる1つのまとまりではなく、3つの別々の文に散らばっているからです。どんなキャラクターかを説明し、構造化されたバージョンを生成し、同じキャンバス上で実際のレンダーに対してテストできます。無料クレジットで最初のラウンドをカバーできます。